중소기업에서는 새로운 분야마다 인력을 충원하기보다, 기존 인력이 더 넓은 범위를 맡아주기를 기대하는 경우가 많다고 느끼고 있습니다. 서버와 스토리지, OS, 때로는 VM까지 다루는 업무에서도 그 위에 올라가는 플랫폼을 이해하고 지원할 수 있는 역량이 점차 필요해지고 있습니다.
기존 인프라 지원 범위를 플랫폼까지 넓히려면 서비스들이 어떻게 연결되는지 알아야 합니다. 설치한 서비스가 실제로 동작하는지, 문제가 생기면 어디부터 확인할지까지 설명할 수 있는 것을 목표로 삼았습니다.
교육에서 배운 내용을 바탕으로 사내에 실습 플랫폼을 구축하고, 함께 공부하는 사람들이 필요한 단계부터 시작할 수 있도록 KVM 스냅샷을 준비했습니다. 각 단계에서 수행할 작업과 도달해야 할 상태도 함께 정리했습니다.
플랫폼까지 지원한다는 것은 무엇을 더 확인한다는 뜻일까요
서버의 전원이 켜지고 OS에 접속할 수 있으면 다음 작업을 시작할 기반이 마련됩니다. VM이 정상적으로 실행되고 필요한 디스크와 네트워크를 사용할 수 있는지도 확인할 수 있습니다. 플랫폼으로 지원 범위를 넓히면 그 위에서 실행되는 서비스까지 질문이 이어집니다.
예를 들어 배포한 프로그램이 사용자 요청을 받지 못한다면 어느 구간을 확인해야 할까요. 새 이미지는 만들어졌는데 실제 서비스가 이전 버전으로 응답한다면 무엇을 비교해야 할까요. 로그인에는 성공했지만 필요한 기능을 사용할 수 없다면 계정과 권한 중 어디를 살펴봐야 할까요.
이 질문에 답하려면 서비스가 실행되는 위치와 연결, 저장된 데이터, 접근 권한을 함께 봐야 합니다. 그래서 실습에서도 도구를 설치한 뒤 변경을 하나씩 적용하고, 어느 구성 요소가 반응했는지와 결과가 남은 위치를 확인하도록 했습니다.
교육 내용을 사내 장비 위에 연결했습니다
이전에 포스팅한 교육 과정에서는 Kubernetes, CI/CD, 인증, 관측, 저장소의 원리와 실습 절차를 다뤘습니다. GitLab·Harbor·Argo CD를 연결하는 교육 글도 이미지 생성부터 배포와 실제 응답 확인까지 다루고 있습니다. 이번 작업에서는 그 흐름을 사내 장비에서 다시 구성하고, 함께 실습할 수 있는 상태와 결과를 준비했습니다.
실습 대상은 이미 학습된 모델을 배포하고 교체하는 과정으로 정했습니다. GitLab과 Harbor, Argo CD가 연결된 배포 경로를 만들고, vLLM이 모델을 실행하며, 응답과 관측 기록까지 확인하도록 구성했습니다. 모델 학습 파이프라인은 이번 구축 범위에 포함하지 않았습니다.
장비 구성은 KVM 물리 호스트 두 대와 별도의 GPU 서버 한 대입니다. KVM 위에 control-plane VM 한 대와 CPU worker VM 세 대를 만들었고, A100 PCIe 80GB 한 장이 있는 서버는 베어메탈 GPU worker로 참여시켰습니다. 플랫폼 서비스는 CPU worker에, 모델 실행은 GPU worker에 배치한 구성입니다.
이 배치를 이해하면 플랫폼 서비스와 모델 실행이 어떤 자원을 사용하는지 구분할 수 있습니다. 동시에 control-plane이 한 대라는 점, GPU worker가 VM이 아니라는 점도 알 수 있습니다. 나중에 장애 범위나 복원 대상을 판단할 때 필요한 정보입니다.
물리 호스트 안의 VM과 별도 GPU 서버
KVM Host A 안에 Control plane VM과 CPU worker 01, Host B 안에 CPU worker 02와 03이 있습니다. 별도 A100 물리 서버가 GPU worker로 참여합니다.
| 항목 | 이전에 포스팅한 교육 과정의 구성 | 이번 사내 실습 구성 |
|---|---|---|
| Kubernetes 기반 | RKE2 기반 교육 | kubeadm 기반 클러스터 |
| CI 이미지 빌드 | Rootless BuildKit | Kubernetes executor와 Docker-in-Docker |
| 모델 작업 | Ray·MLflow·KServe를 연결하는 학습·배포 예제 | 준비된 모델을 vLLM으로 배포·교체 |
| 서빙 검증 대상 | RayJob·MLflow와 KServe V2 추론 경로 | vLLM 모델 전환과 SSE 응답·로그·trace 연결 |
처음부터 다시 시작할 수 있는 지점을 나눴습니다
함께 공부하는 사람마다 필요한 시작점은 다를 수 있습니다. VM의 OS 준비부터 해보고 싶은 사람이 있고, Kubernetes 초기화 과정을 익히고 싶은 사람도 있습니다. 이미 만들어진 플랫폼에서 배포와 관측을 연습하고 싶은 경우도 있습니다.
이런 학습 경로를 준비하기 위해 VM 네 대의 상태를 S0(OS 준비), S1(Kubernetes 초기화 전), S2(CPU 클러스터 준비), S3(플랫폼 사용 준비)로 나눠 저장했습니다. 각 지점은 특정 작업을 시작하기 위한 상태이면서, 앞선 작업을 마쳤을 때 도달해야 할 상태이기도 합니다.
S1은 containerd·kubeadm·kubelet과 설정·이미지를 준비했지만 init·join은 실행하지 않은 상태입니다. S2에서는 control-plane 한 대와 CPU worker 세 대의 Ready 상태와 기본 통신까지 확인했습니다. GPU worker 참여와 플랫폼 설치는 S2 이후에 진행했습니다.
OS 준비에서 플랫폼 사용까지
-
S0 ·OS 준비
VM 네 대의 OS·네트워크·guest-agent·추가 디스크를 준비했습니다.
다음 실습 → containerd와 Kubernetes 패키지, 설정·이미지를 준비합니다.
-
S1 ·클러스터 초기화 전
containerd·kubeadm·kubelet과 설정·이미지가 준비돼 있습니다. init·join은 아직 실행하지 않았습니다.
다음 실습 → control-plane을 초기화하고 worker 세 대를 참여시킨 뒤 CNI와 노드 간 통신을 확인합니다.
-
S2 ·CPU 클러스터 준비
control-plane 한 대와 CPU worker 세 대가 Ready이며 기본 통신을 확인했습니다.
다음 실습 → GPU worker를 참여시키고 CI/CD·인증·관측·저장소를 구축합니다.
-
S3 ·플랫폼 사용 준비
S3-platform-ready에는 CI/CD·SSO·Gateway·관측·스토리지를 구성한 VM 상태를 저장했습니다.
다음 실습 → 모델을 배포·교체하고 로그인, SSE 응답, 로그·trace를 확인합니다.
저장 대상은 VM 네 대입니다. 물리 KVM 호스트와 베어메탈 GPU 서버의 OS·드라이버·모델 캐시는 VM을 복원해도 함께 돌아가지 않습니다.
실습의 완료 여부는 각 단계에서 가능해야 하는 동작으로 판단합니다. OS 단계에서는 접속과 네트워크, 클러스터 단계에서는 노드 사이의 통신, 플랫폼 단계에서는 실제 배포와 요청 결과를 확인합니다.
네 지점 모두 생성과 재기동을 확인했으며, 실제 저장 지점으로 되돌리는 시험은 S2에서 수행했습니다. 저장 이후 VM에 만든 파일과 Kubernetes ConfigMap이 복원 후 사라졌는지 확인했고, CPU 노드 네 대의 Ready 상태와 HTTP·DNS·Service 통신 검사 12개도 통과했습니다. S0·S1·S3의 개별 되돌림 시험은 후속 확인 항목으로 남아 있습니다.
각 단계에서 확인할 결과를 함께 남겼습니다
이번 구축 과정에는 노드 상태만으로 다음 단계에 넘어가기 어려웠던 사례가 있습니다. 노드가 Ready이고 ping도 성공했지만, 다른 worker의 Pod로 보내는 HTTP 요청은 실패했습니다. 기록에서는 Flannel VXLAN 경로의 checksum offload 문제를 재현했고, 관련 설정을 조정한 뒤 통신 결과를 다시 확인했습니다.
이 경험은 실습의 도달 조건을 구체적으로 만드는 데 도움이 됩니다. Kubernetes가 설치됐다는 사실에 더해, 실제로 필요한 통신이 되는지 확인해야 플랫폼을 올릴 다음 단계를 진행할 수 있습니다. 실습 안내에도 정상 상태의 이름과 함께 그 상태에서 성공해야 하는 요청을 남겨두었습니다.
모델 배포에서는 같은 생각을 응답 검증으로 이어갔습니다. 이번 실습은 Gemma를 배포한 뒤 Qwen으로 전환하고, 다시 Gemma로 돌아오는 순서로 진행했습니다. 각 배포에서 무엇이 달라졌고 어떤 모델이 응답하는지를 비교할 수 있는 흐름입니다.
CI는 validate, build, promote, verify의 네 단계로 구성했습니다. 준비한 프로필과 이미지 정보를 확인하고 이미지를 빌드한 뒤, 수동 promote를 통해 배포 Git의 release.yaml을 갱신합니다. Argo CD가 그 변경을 반영하면 verify 단계에서 해당 commit의 상태와 실제 모델 응답을 확인합니다.
이미지와 모델을 묶어 배포하는 과정
설명용 배포 흐름. Harbor 이미지의 digest와 RustFS 모델 manifest 참조를 release.yaml에 기록하고, Argo CD가 반영한 뒤 CI에서 응답을 확인합니다.
흐름을 단계별로 살펴보기
- Runner가 실행 이미지를 Harbor에 올립니다. 모델 파일은 RustFS에 보관합니다.
- 이미지 digest와 모델 manifest 참조를 release.yaml에 함께 기록합니다.
- Argo CD가 Git 변경을 반영합니다. 기존 Pod를 내리고 새 모델을 준비하는 동안 요청이 중단됩니다.
- CI가 배포 commit을 대조하고 내부 Service의 SSE 응답 3회와 trace 연결을 확인합니다.
- Git에 기록한 이미지·모델 조합과 실제 응답을 맞춰 봅니다.
이 과정에서 CI가 하는 Git 변경과 Argo CD의 배포 동작을 구분했습니다. verify는 Argo API를 조회해 정확한 배포 commit을 기다립니다. CI가 Argo에 배포를 직접 명령하는 것과 배포 결과를 읽어 확인하는 것은 다른 동작입니다.
배포 대상으로 함께 관리한 것은 실행 이미지와 모델 파일입니다. Harbor에는 실행 환경인 OCI 이미지를 두고, RustFS에는 모델 manifest와 가중치를 두었습니다. 모델을 준비하는 initContainer가 manifest와 파일의 SHA-256을 확인한 뒤 GPU 서버의 로컬 캐시에 저장하도록 구성했습니다. 기존 저장소·버전 관리 교육 글에서 다룬 역할 구분을 이번 모델 실행 경로에 적용한 부분입니다.
세 번의 배포가 모두 네 단계를 통과했습니다. 배포마다 짧은 SSE 요청을 세 번씩 보내 총 아홉 번의 응답과 client·server trace 연결을 확인했습니다. 마지막 Gemma 복귀에서는 기존 캐시를 사용해 다운로드 없이 파일 해시를 확인한 뒤 모델을 실행한 기록도 남겼습니다.
이 결과는 모델 전환과 검증 경로가 동작했다는 기능 확인입니다. 동시 사용자 부하나 모델 품질을 비교한 벤치마크는 아닙니다. 또한 GPU 한 장에서 Recreate 방식으로 모델을 교체하므로 로딩 중에는 요청이 중단됩니다. 실습하는 사람도 이 구간을 예상하고, 새 모델의 응답이 돌아오는 시점을 확인할 수 있어야 합니다.
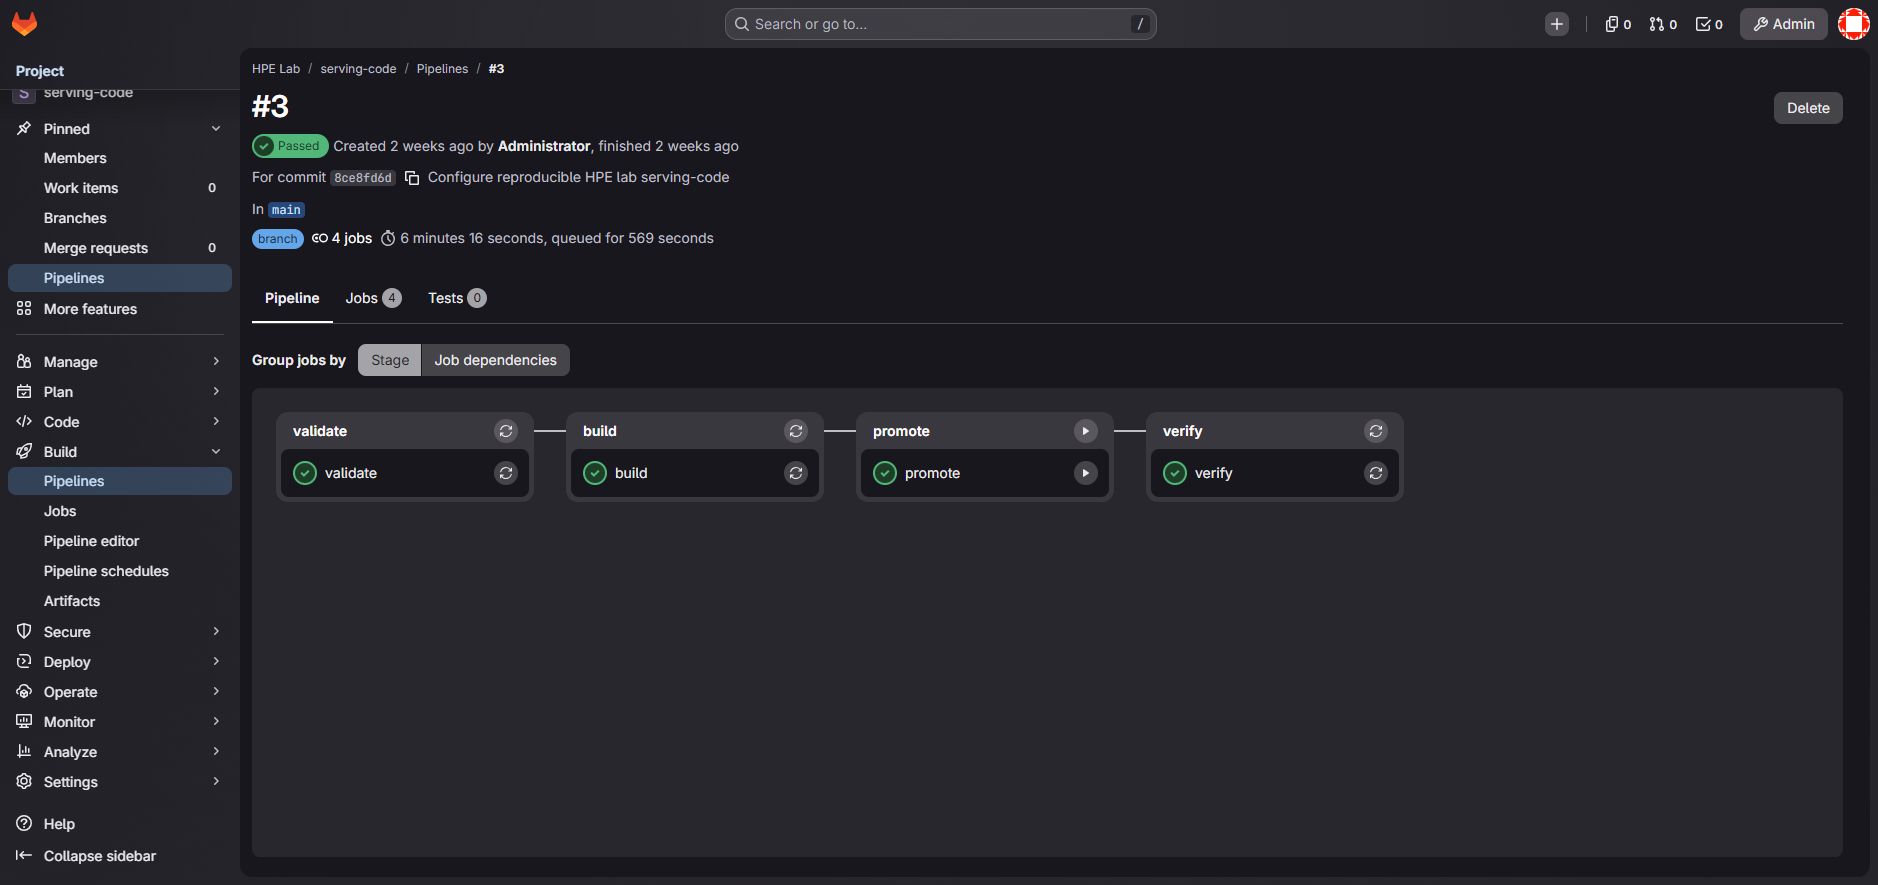
Pipeline #3에서 validate → build → promote → verify가 모두 Passed로 표시됩니다. 프로필·이미지 확인과 빌드, 배포 선언 갱신, 배포·응답 검증으로 이어진 실행 이력입니다.
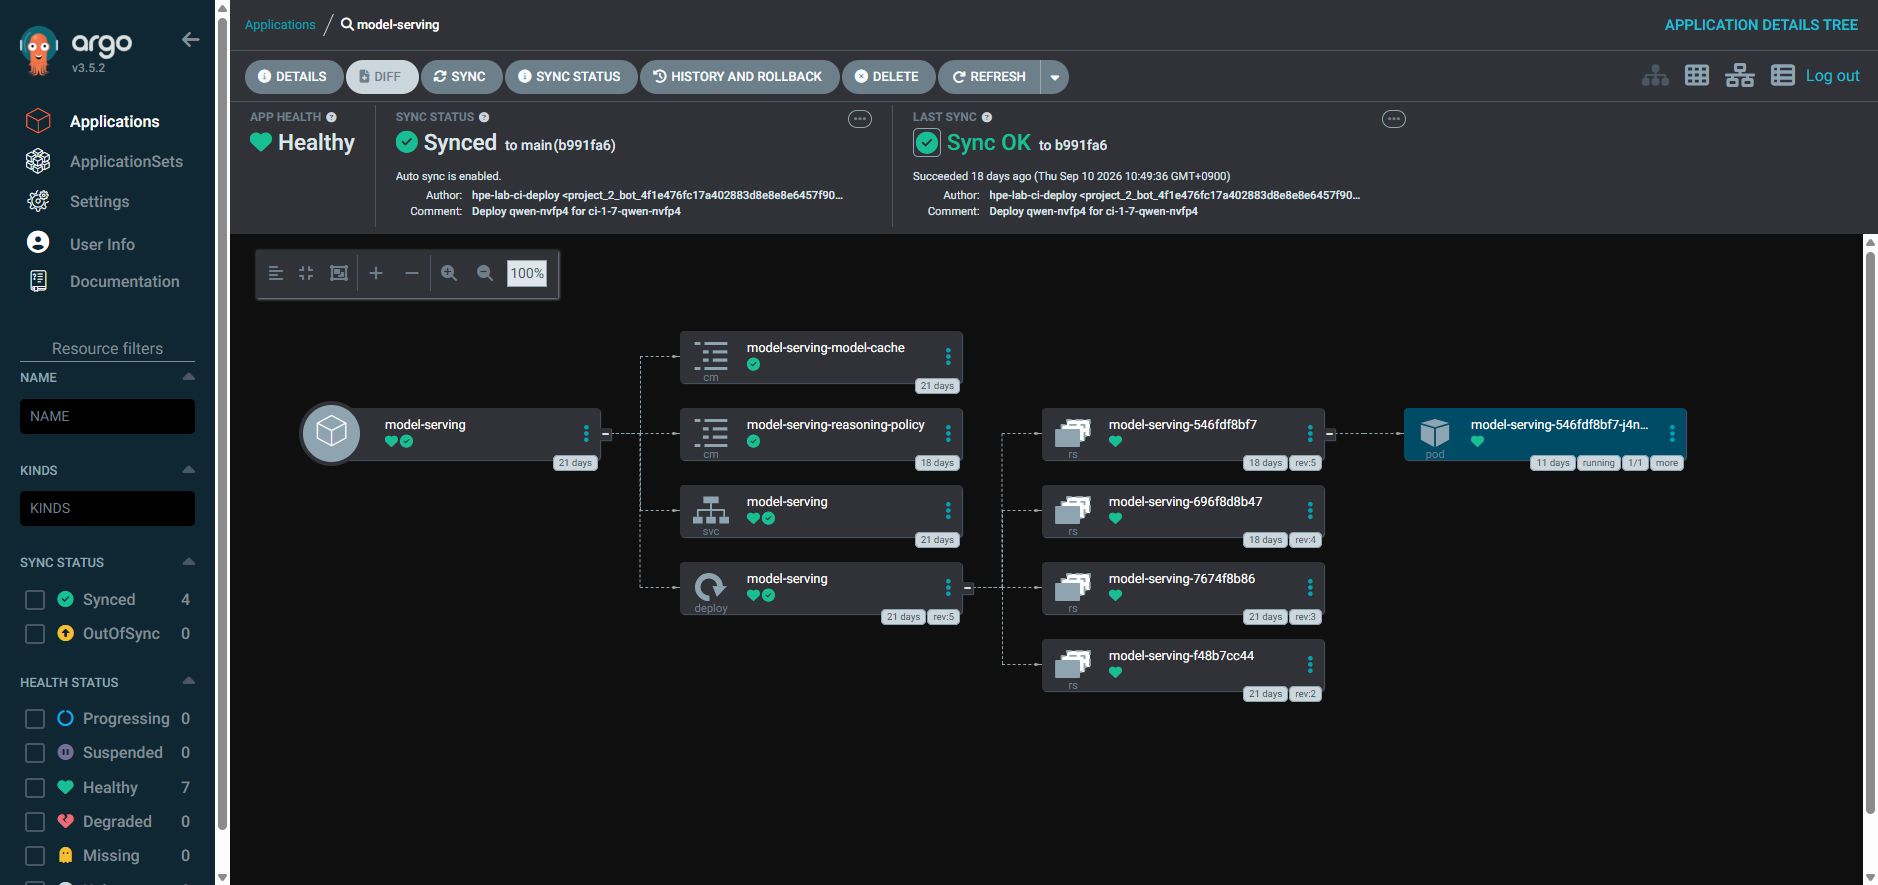
Argo CD의 model-serving 화면은 Qwen NVFP4 배포가 main의 b991fa6에 Synced되고 Healthy인 상태를 보여줍니다. Deployment → ReplicaSet → Pod 연결에서 배포 리소스와 실행 Pod의 관계를 확인할 수 있습니다.
사용자의 요청에서 관측 기록까지 따라갈 수 있도록 했습니다
예를 들어 모델이 내부에서는 응답하지만 외부에서는 연결되지 않는다면, 모델 실행과 외부 진입 경로를 나눠 확인해야 합니다. 이런 상황을 설명할 수 있도록 사용자의 요청이 모델에 도착하고 응답으로 돌아오는 경로를 정리했습니다.
이번 환경의 외부 요청은 MetalLB가 광고하는 주소로 들어와 NGINX 데이터 Pod를 거쳐 vLLM의 API에 도착합니다. vLLM 안에서는 FastAPI와 Uvicorn이 HTTP 요청을 처리하고, 엔진과 GPU 연산을 거쳐 생성한 토큰이 SSE로 돌아옵니다.
FastAPI는 별도로 만든 애플리케이션 서버가 아니라 vLLM 내부의 API 계층입니다. NGINX Gateway Fabric은 Service와 EndpointSlice 정보를 사용해 구성을 만들고, 확인한 NGINX 설정의 실제 upstream은 vLLM Pod IP였습니다. 요청이 통과하는 경로와 그 경로를 설정하는 구성 요소를 나눠 볼 수 있도록 도식에 반영했습니다.
요청은 vLLM으로, 응답은 토큰 단위로
설명용 요청 흐름. Client의 HTTP 요청은 NGINX에서 vLLM Pod IP로 전달됩니다. vLLM 내부 API와 엔진이 생성한 토큰은 NGINX를 거쳐 SSE로 돌아옵니다. 점선은 Service·EndpointSlice를 읽어 upstream을 만드는 설정 경로입니다.
KV cache
흐름을 단계별로 살펴보기
- Client가 MetalLB의 VIP로 보낸 HTTP 요청이 NGINX에 도착합니다.
- NGINX가 upstream에 등록된 vLLM Pod IP:8000으로 요청을 전달합니다.
- vLLM 내부 API가 요청을 받고, 엔진이 A100 GPU로 모델을 실행합니다.
- 생성한 토큰이 NGINX를 거쳐 Client에 차례로 도착합니다. 응답 buffering은 꺼져 있습니다.
- 실선은 요청과 SSE 응답, 점선은 NGINX upstream을 만드는 설정 정보입니다.
응답이 정상적으로 돌아온 뒤에는 그 요청이 남긴 기록을 찾도록 준비했습니다. Prometheus에서는 요청과 자원 상태의 지표를 보고, Loki에서는 실행·접근 로그를 찾으며, Tempo에서는 요청의 trace를 확인합니다. Grafana에서는 이 자료를 함께 살펴볼 수 있습니다. 기본 개념은 기존 관측성 교육 글에 연결하고, 실습에서는 방금 보낸 요청과 기록이 어떻게 이어지는지에 집중합니다.
첫 토큰이 돌아오기까지의 시간과 전체 응답 시간도 남겼습니다. 이를 GPU 연산 시간과 동일하게 해석하지는 않습니다. 클라이언트에서 측정한 값에는 연결과 대기, 모델의 입력 처리, 네트워크 등 여러 구간이 함께 들어 있습니다. 숫자를 읽을 때 어디에서 잰 값인지까지 설명하는 것이 실습의 일부입니다.
같은 요청이 남긴 세 가지 기록
client와 vLLM span은 부모 ID로 연결됩니다. NGINX는 자체 span 대신 traceparent를 access log에 남깁니다. metrics·logs·traces는 서로 다른 데이터 형태와 수집 경로입니다.
관측 범위에도 구분이 있습니다. 이번 환경에서는 client와 vLLM span을 연결했고, NGINX는 자체 span 대신 access log에 traceparent를 남깁니다. 모든 구성 요소가 하나씩 span을 만든 것처럼 읽어서는 안 됩니다.
모델 전환 CI는 내부 Service 경로에서 검증했습니다. 외부 Gateway 경로에서는 SSE 요청 세 번의 응답과 로그·trace 연결을 확인했습니다.
로그인과 권한도 실제 사용 범위에 맞춰 확인했습니다
동료가 플랫폼을 사용하려면 관리 화면에 접근할 수 있어야 합니다. 이번에는 Keycloak을 GitLab·Argo CD·Grafana에 연결하고, 같은 로그인 기반에서 각 애플리케이션의 역할이 적용되도록 구성했습니다.
실습 기록에는 두 교육 계정으로 로그인한 뒤 관리자와 읽기 역할의 차이를 확인한 결과가 있습니다. 첫 애플리케이션에서 Keycloak 로그인을 마친 뒤 다른 두 애플리케이션에서도 추가 비밀번호 입력 없이 인증되는지, 인증 이후 실제 권한은 어떻게 다른지를 확인했습니다.
한 로그인과 앱별 권한, 그리고 적용 제외
Keycloak OIDC를 연결한 앱은 GitLab·Argo CD·Grafana입니다. 앱별 권한은 별도 정책이며 Harbor·RustFS는 로컬 인증, 모델 API는 Keycloak OIDC 미적용입니다.
이를 통해 로그인 성공과 기능 사용 권한을 나눠 살펴볼 수 있습니다. Keycloak과 Argo CD 권한을 다룬 교육 글의 내용을 실제 관리 화면과 연결해 보는 부분입니다.
SSO의 적용 대상은 위 세 애플리케이션입니다. Harbor와 RustFS 관리 콘솔은 로컬 인증을 사용하며, 모델 API에는 Keycloak OIDC를 적용하지 않았습니다. CI에서 사용하는 token과 조회 계정도 사람의 로그인 세션과 별도로 관리합니다. 이 범위를 명확하게 알고 있어야 사용자가 어느 서비스에서 어떤 인증을 거치는지 설명할 수 있습니다.
돌아갈 지점을 준비하면서 저장 범위도 구분했습니다
스냅샷으로 돌아갈 지점을 만들 때는 무엇이 저장되는지부터 확인해야 합니다. 이 환경에는 컨테이너 이미지, 모델 원본, GPU 서버의 모델 캐시, 플랫폼 서비스의 데이터가 서로 다른 위치에 있습니다.
Harbor의 이미지와 RustFS의 모델 파일은 배포에 필요한 자료입니다. GitLab·Keycloak 등의 상태와 관측 데이터는 VM 내부의 local-path PVC에 저장됩니다. GPU 서버의 모델 캐시는 VM 밖에 있습니다. RustFS 역시 이번 구성에서는 local-path를 사용하는 단일 replica이며, 노드 간 공유와 고가용성을 제공하는 저장소로 검증한 상태는 아닙니다.
VM 네 대를 함께 저장한 복원 범위
S3-platform-ready는 checkpoint 이름입니다. 객체 저장소 S3와 다른 뜻입니다. VM의 OS·etcd·local-path 데이터는 포함하고 물리 KVM 호스트와 GPU 서버의 OS·드라이버·캐시는 제외합니다. 실제 되돌림 시험은 S2만 수행했습니다.
S3-platform-ready에는 VM의 OS와 Kubernetes 설정·etcd, VM 내부 local-path PVC에 있는 플랫폼 데이터가 포함됩니다. 반면 물리 KVM 호스트의 OS와 네트워크 설정, 베어메탈 GPU 서버의 OS·드라이버·모델 캐시는 포함되지 않습니다. 구성된 플랫폼 단계로 돌아가더라도 GPU 쪽 상태를 함께 확인해야 하는 이유입니다.
VM 네 대도 같은 저장 지점을 하나의 세트로 다룹니다. 서로 다른 시점의 VM을 임의로 섞어 실행하는 방식으로 준비하지 않았습니다. 복원 이후에는 VM의 기동 여부에 더해 클러스터와 서비스, 실제 요청이 기대한 상태로 돌아왔는지 확인하도록 절차를 정리했습니다.
S3를 생성한 뒤 VM을 재기동하고, 노드 다섯 대의 Ready 상태와 PVC 13개의 Bound 상태를 확인했습니다. Argo CD·SSO·S3 IAM과 SSE 요청 세 번, 로그·trace 연결도 점검했습니다. S3 저장 지점으로 실제 되돌리는 시험은 아직 수행하지 않았으며, 실제 되돌림을 확인한 지점은 앞서 설명한 S2입니다. Rook/Ceph는 실습용 디스크와 준비 조건을 확인한 단계로, 설치와 스토리지 동작까지 완료한 구성에는 포함하지 않았습니다.
실습을 다시 시작할 때는 저장 시점과 포함된 데이터뿐 아니라, 스냅샷 밖에 있는 장비의 상태도 함께 확인해야 합니다.
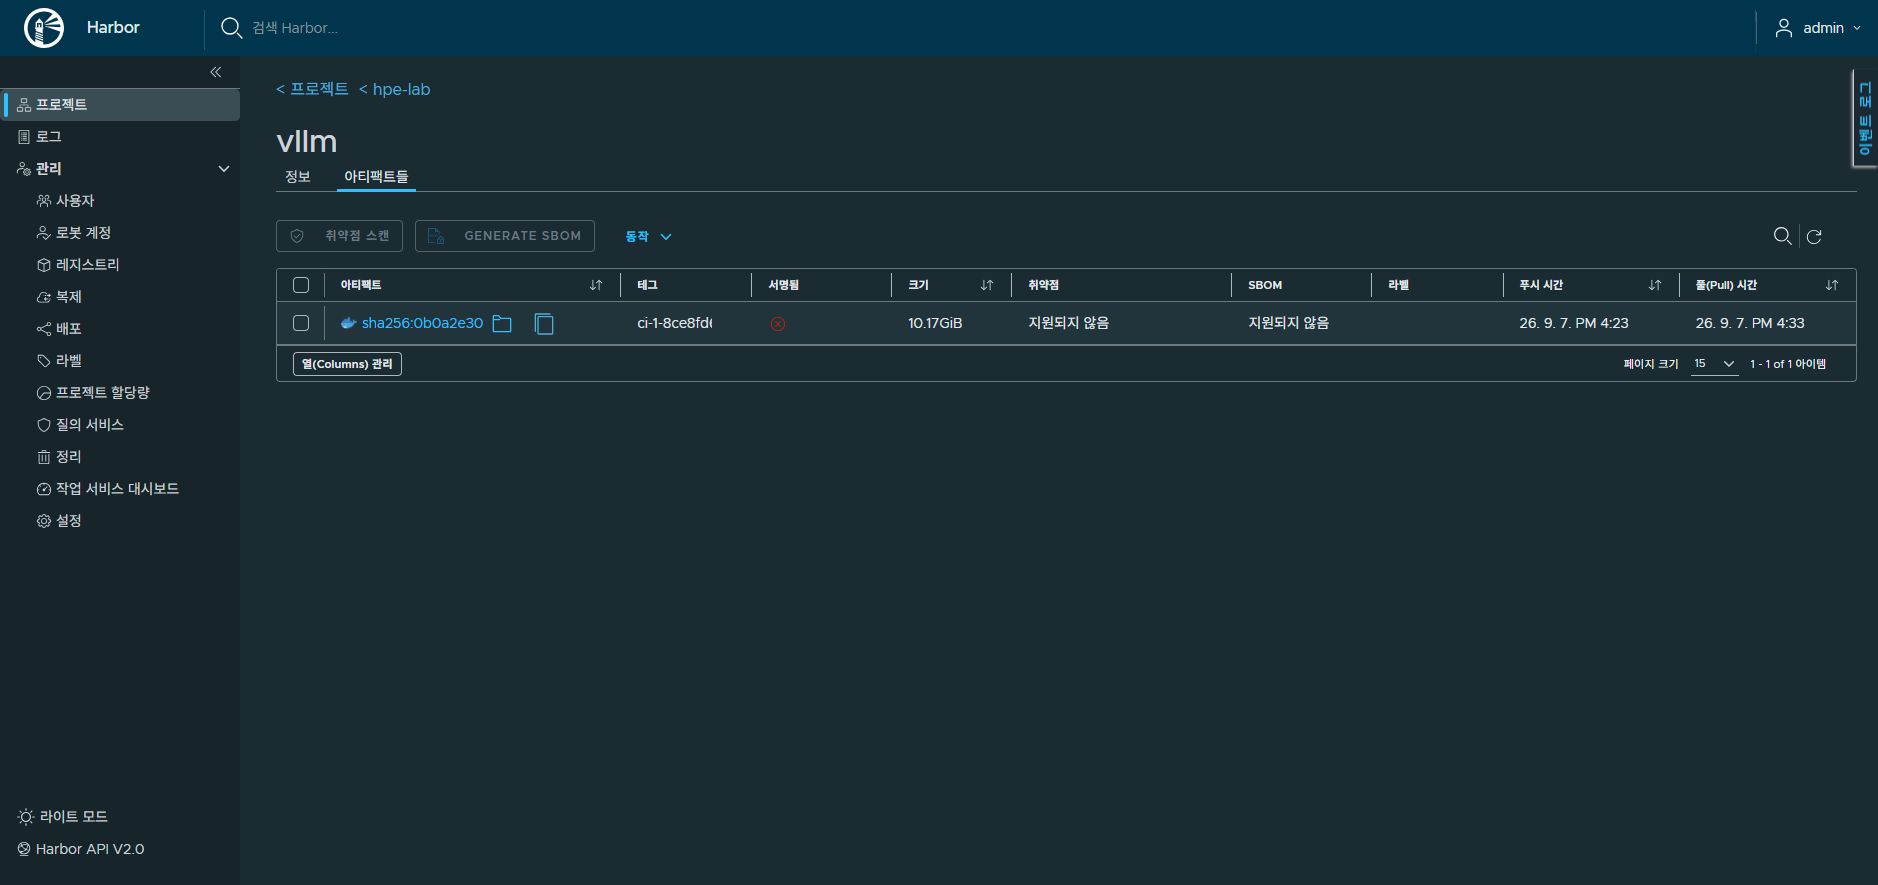
Harbor의 hpe-lab/vllm 저장소에서 실행 이미지의 digest와 CI 태그를 확인할 수 있습니다. 모델 가중치는 RustFS에 보관하고, Harbor의 digest로는 배포에 사용할 실행 이미지를 식별합니다.
함께 설명하고 지원할 수 있는 범위를 넓혀가고 있습니다
물리 배치, 배포, 추론 요청, 로그인, 관측, 저장소의 여섯 도식은 사내 실습 환경에서 같은 요청과 변경을 따라가기 위한 자료입니다.
동료가 배포를 수행한 뒤 어떤 모델이 응답하는지 확인하고, 그 요청의 로그와 trace를 찾아 설명할 수 있다면 플랫폼의 연결 관계를 이해하는 데 도움이 될 것입니다. 처음 구축하는 과정과 이미 구성된 서비스를 사용하는 과정을 나누어 준비한 이유도 여기에 있습니다.
구축과 기능 검증 결과는 기록으로 남겼지만, 이 환경을 활용한 학습이 실제 지원 역량으로 얼마나 이어지는지는 아직 확인하지 못했습니다. 다음에는 S0·S1·S3의 개별 되돌림 시험을 보완하고, 동료들이 배포와 요청 기록을 직접 따라가면서 어느 설명이 부족한지 확인하려고 합니다.